โดย Mark McDowellเผยแพร่: อัปเดต: อ่าน 11 นาที
Perplexity คืออะไร และทำอย่างไรให้เว็บไซต์ถูกอ้างอิง
Perplexity คือเครื่องมือค้นหาที่ใช้ AI (Artificial Intelligence) ค้นเว็บแล้วเขียนคำตอบสั้นพร้อมการอ้างอิงแบบมีหมายเลขในทุกคำตอบ เว็บไซต์ของคุณจะถูกอ้างอิงได้เมื่อ PerplexityBot เข้าเว็บไซต์ได้ ข้อมูลบนหน้ายังเป็นปัจจุบัน และมีหัวข้อที่ตอบคำถามของลูกค้าจบในประโยคแรก เพราะ Perplexity ให้คะแนนทีละส่วนของหน้า
ประเด็นสำคัญ
- Perplexity ค้นจากดัชนีของตัวเองและให้คะแนนทีละส่วนของหน้าเว็บ หัวข้อที่ตอบคำถามจบใน 1 ถึง 2 ประโยคแรกจึงถูกยกไปอ้างอิงได้ แม้ส่วนอื่นของหน้าจะพูดเรื่องอื่น
- เอกสารของ Perplexity แนะนำให้เปิด PerplexityBot ทั้งในไฟล์ robots.txt และที่ไฟร์วอลล์ โดยรับคำขอเมื่อชื่อ User Agent และที่อยู่ IP (Internet Protocol) ตรงกับรายการที่ Perplexity เผยแพร่
- ในคำตอบของ AI 285, 098 คำตอบเกี่ยวกับหมวดของ 171 แบรนด์ ที่ Elevate, Primal's AI Visibility Tracker เก็บในเดือนที่ผ่านมา เว็บไซต์ของแบรนด์ถูกอ้างอิงไม่ถึง 1 ใน 5 คำตอบใน 90 แบรนด์
- งานวิจัยต้นฉบับของ GEO (Generative Engine Optimisation) ทดสอบกับ Perplexity และพบว่าคำพูดอ้างอิงกับตัวเลขสถิติทำให้ข้อความจากหน้านั้นถูกใช้มากขึ้น ส่วนการยัดคีย์เวิร์ดได้ผลแย่กว่าหน้าเดิม
- StatCounter วัดได้ว่า Perplexity ส่งการเข้าชมราว 3 ใน 100 ของการเข้าชมเว็บไซต์ในไทยที่มาจากแชตบอต AI งานนี้จึงคุ้มเมื่อทำพร้อมกับ ChatGPT และ Gemini
Perplexity คืออะไร และคนไทยใช้มากแค่ไหน
Perplexity เป็น AI Search หรือ Answer Engine ที่ใช้ AI (Artificial Intelligence) ค้นเว็บ อ่านหน้าที่เจอ แล้วเขียนคำตอบสั้นให้ผู้ใช้ หน้าความช่วยเหลือของ Perplexity ระบุว่าทุกคำตอบมีการอ้างอิงแบบมีหมายเลข ซึ่งลิงก์ไปยังแหล่งที่มาต้นทาง ผู้ใช้จึงเห็นเสมอว่าคำตอบมาจากเว็บไซต์ไหน
ในไทย Perplexity ยังเป็นแพลตฟอร์มเล็ก StatCounter วัดได้ว่าในเดือนที่ผ่านมา Perplexity ส่งการเข้าชมราว 3 ใน 100 ของการเข้าชมเว็บไซต์ในไทยที่มาจากแชตบอต AI อยู่อันดับ 3 รองจาก ChatGPT ที่ราว 7 ใน 10 และ Gemini ที่ราว 1 ใน 4
ข้อมูลของ SimilarWeb สำหรับประเทศไทยในเดือน 2026-04 ให้ภาพเดียวกัน โดย Perplexity AI มีการเข้าชมราว 1 ล้านครั้งต่อเดือน ขณะที่ Gemini มีราว 40 ล้านครั้ง และ ChatGPT ราว 35 ล้านครั้ง
ผมจึงแนะนำให้ทำงานสำหรับ Perplexity พร้อมกับ ChatGPT และ Gemini และใช้ Perplexity เป็นที่ตรวจงาน เพราะ Perplexity แสดงแหล่งที่มาของทุกคำตอบ ถามคำถามของลูกค้าไม่กี่ข้อก็เห็นว่า AI อ้างอิงเว็บไซต์ไหนในหมวดของคุณ
Perplexity SEO คืออะไร
Perplexity SEO คือการทำ SEO (Search Engine Optimisation) ให้ Perplexity เลือกหน้าเว็บหรือชื่อแบรนด์ของคุณไปอ้างอิงในคำตอบ งานมี 2 ส่วน ส่วนแรกคือเว็บไซต์ที่ Crawler ของ Perplexity เข้าได้ และมีหัวข้อที่ตอบคำถามจบในตัว ส่วนที่สองคือชื่อแบรนด์บนเว็บไซต์อื่นที่ Perplexity อ้างอิงในหมวดของคุณ
Perplexity หาและเลือกแหล่งข้อมูลอย่างไร
Perplexity เลือกแหล่งข้อมูลจากดัชนีค้นหาของตัวเอง แล้วจัดอันดับทั้งระดับหน้าเว็บและระดับส่วนย่อยของหน้า บทความของทีมวิศวกร Perplexity อธิบายว่าดัชนีนี้ติดตาม URL (Uniform Resource Locator) หรือที่อยู่หน้าเว็บกว่า 200,000 ล้านรายการ ระบบใช้โมเดล Machine Learning ตัดสินว่าหน้าไหนควรเก็บใหม่และเก็บเมื่อไร และเก็บหน้าจากโดเมนที่ระบบประเมินว่าน่าเชื่อถือไว้ให้ดึงได้เร็วที่สุด
เมื่อผู้ใช้ถาม ระบบทำงาน 4 ขั้นตามบทความเดียวกัน
- ค้นหน้าที่อาจตอบได้ 2 วิธีพร้อมกัน วิธีแรกจับคู่คำ วิธีที่สองจับคู่ความหมาย
- ตัดหน้าที่ไม่ตอบคำถามหรือมีข้อมูลล้าสมัยออกตั้งแต่รอบแรก
- จัดอันดับหลายรอบ รอบท้ายใช้โมเดลที่อ่านคำถามคู่กับข้อความแต่ละช่วง
- ให้คะแนนทั้งหน้าและทีละส่วนของหน้า แล้วส่งส่วนที่ตรงคำถามที่สุดให้โมเดลเขียนคำตอบ
ขั้นที่ 4 คือส่วนที่เจ้าของเว็บไซต์ควบคุมได้มากที่สุด หัวข้อที่ตอบคำถามของตัวเองจบใน 1 ถึง 2 ประโยคแรกถูกยกไปใช้ได้ แม้ส่วนอื่นของหน้าจะพูดเรื่องอื่น ส่วนขั้นที่ 2 บอกว่าหน้าที่ข้อมูลเก่าเสี่ยงหลุดตั้งแต่รอบแรก ผมแนะนำให้หน้าสำคัญทุกหน้าแสดงวันที่แก้ไขล่าสุด และแก้ตัวเลขทุกครั้งที่มีข้อมูลใหม่
Source Label ของ Perplexity ตรวจอะไร
Source Label คือป้ายที่ Perplexity ติดให้แหล่งที่มาบางแห่ง มี 3 ประเภท ได้แก่ Government สำหรับเว็บไซต์หน่วยงานรัฐ Academic สำหรับเว็บไซต์วิชาการ และ Trusted สำหรับเว็บไซต์ที่ปรากฏในผลบ่อยและเผยแพร่ข้อมูลในเรื่องที่ตัวเองเชี่ยวชาญ แหล่งที่มีป้ายจะมีไอคอนรูปโล่อยู่ข้างการอ้างอิง
หน้าความช่วยเหลือเรื่อง Source Label ระบุว่า Perplexity ให้ป้ายกับทั้งเว็บไซต์ ไม่ได้ให้ทีละหน้า ภาพด้านล่างคือส่วนของหน้านี้ที่ระบุคำถาม 3 ข้อที่ใช้ตรวจก่อนให้ป้าย
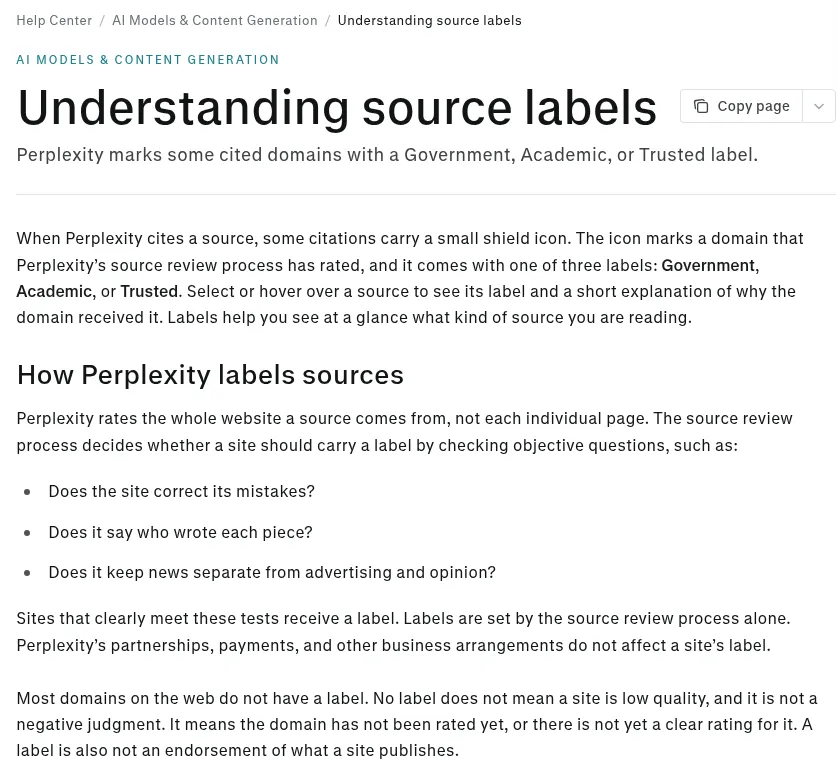
คำถาม 3 ข้อนั้นคือ เว็บไซต์แก้ข้อผิดพลาดของตัวเองหรือไม่ ระบุหรือไม่ว่าใครเขียนแต่ละชิ้น และแยกข่าวออกจากโฆษณาและความเห็นหรือไม่ Perplexity ระบุว่าการเป็นพาร์ตเนอร์หรือการจ่ายเงินไม่มีผลกับป้าย และเว็บไซต์ส่วนใหญ่ไม่มีป้าย ซึ่งไม่ได้แปลว่าเว็บไซต์นั้นคุณภาพต่ำ
Perplexity อธิบายว่าป้ายมีไว้ให้ผู้อ่านรู้ว่ากำลังอ่านแหล่งข้อมูลแบบไหน ผมจึงมองป้ายเป็นข้อมูลสำหรับผู้อ่านมากกว่าปัจจัยจัดอันดับ แต่ 3 คำถามนี้ใช้เป็นรายการตรวจเว็บไซต์ธุรกิจได้ทันที ใส่ชื่อและตำแหน่งผู้เขียนในทุกบทความ แก้ข้อผิดพลาดพร้อมหมายเหตุสั้นๆ และระบุให้ชัดว่าเนื้อหาไหนเป็นโฆษณาหรือได้รับการสนับสนุน
ควรเปิดให้ Crawler ตัวไหนของ Perplexity เข้าเว็บไซต์
ตัวที่ต้องเปิดคือ PerplexityBot เพราะเป็น Crawler ที่ทำให้เว็บไซต์แสดงและมีลิงก์ในผลการค้นหาของ Perplexity เอกสาร Crawler ของ Perplexity ระบุว่า PerplexityBot ไม่ได้ใช้เก็บเนื้อหาไปฝึกโมเดล AI และแนะนำให้เปิดทั้งในไฟล์ robots.txt และที่ไฟร์วอลล์
Perplexity มี User Agent หรือชื่อที่บอตใช้แนะนำตัวเมื่อขอเปิดหน้าเว็บ 2 ตัว
| User Agent | หน้าที่ | ไฟล์ robots.txt |
|---|---|---|
| PerplexityBot | เก็บหน้าเว็บเพื่อแสดงและลิงก์ในผลการค้นหาของ Perplexity | ทำตาม |
| Perplexity-User | เปิดหน้าเว็บเมื่อผู้ใช้ถามคำถามที่ต้องใช้หน้านั้น | โดยทั่วไปไม่ทำตาม เพราะผู้ใช้เป็นผู้สั่ง |
บรรทัดด้านล่างเปิดให้ PerplexityBot เข้าทั้งเว็บไซต์ เอกสารฉบับเดียวกันระบุว่าระบบของ Perplexity อาจใช้เวลาถึง 24 ชั่วโมงในการปรับตามไฟล์ที่แก้
User-agent: PerplexityBot
Allow: /
ไฟล์ robots.txt อย่างเดียวยังไม่พอ ไฟร์วอลล์หรือบริการป้องกันบอตอาจปฏิเสธบอตที่ไม่รู้จักก่อนที่บอตจะได้อ่านไฟล์นี้ Perplexity จึงเผยแพร่รายการที่อยู่ IP (Internet Protocol) ของทั้ง 2 ตัว และแนะนำให้ตั้งกฎใน WAF (Web Application Firewall) ที่รับคำขอเมื่อทั้งชื่อ User Agent และที่อยู่ IP ตรงกับรายการ เอกสารมีขั้นตอนสำหรับ Cloudflare และ AWS (Amazon Web Services)
ภาพด้านล่างคือตารางในเอกสาร Crawler ของ Perplexity ซึ่งระบุชื่อ User Agent แบบเต็ม ลิงก์ไปยังรายการที่อยู่ IP และหมายเหตุว่า Perplexity-User โดยทั่วไปไม่ทำตามไฟล์ robots.txt
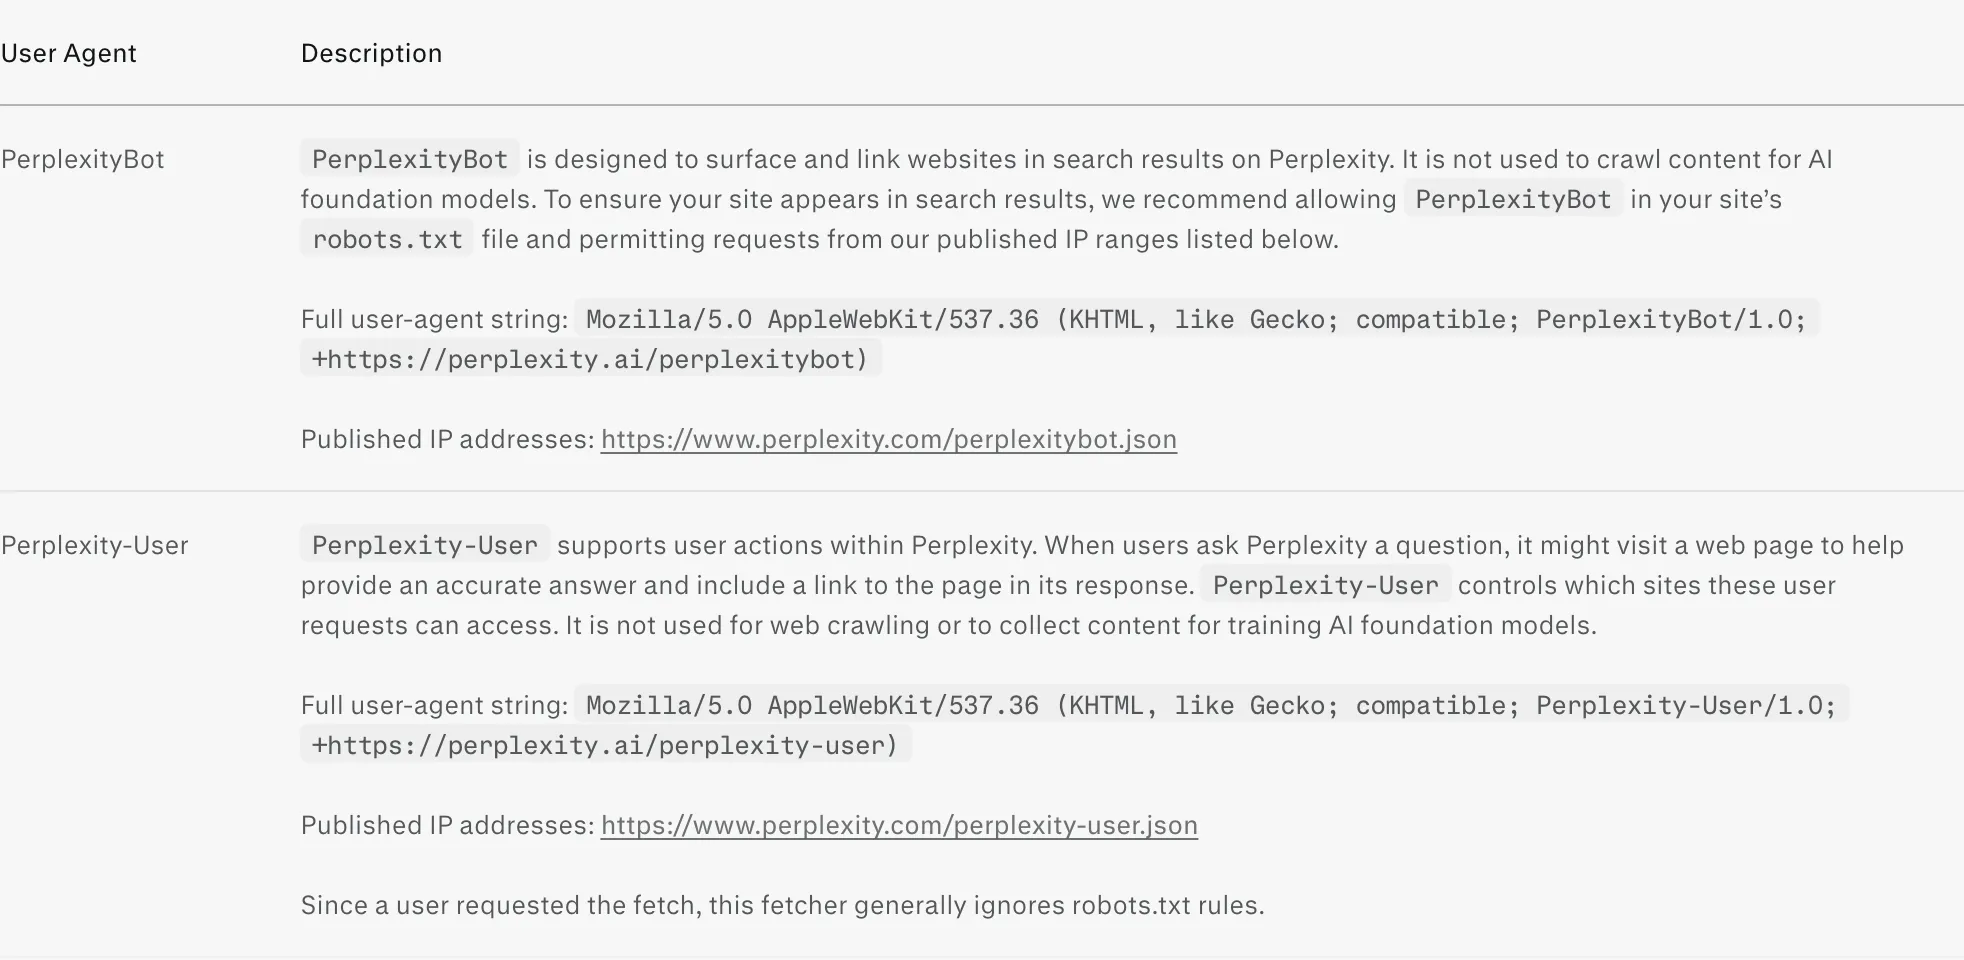
ถ้าแก้ได้เพียงเรื่องเดียวในสัปดาห์นี้ ผมเลือกตรวจไฟร์วอลล์ เพราะงานที่เหลือทุกขั้นเริ่มจากการที่ PerplexityBot เข้าเว็บไซต์ได้
Perplexity หาแหล่งข้อมูลต่างจาก ChatGPT และ Gemini อย่างไร
ความต่างหลักอยู่ที่ดัชนีที่แต่ละแพลตฟอร์มใช้ Perplexity ค้นจากดัชนีของตัวเอง Gemini ค้นจากดัชนีของ Google Search ส่วน ChatGPT ใช้ผู้ให้บริการค้นหาที่ทำงานร่วมกับ OpenAI ซึ่งรวม Microsoft และใช้ Crawler ของ OpenAI เอง บอตที่ต้องเปิดจึงต่างกันด้วย
| Perplexity | ChatGPT | Gemini | |
|---|---|---|---|
| หน้าเว็บมาจากไหน | ดัชนีของ Perplexity | ผู้ให้บริการค้นหาที่รวม Microsoft และการเก็บข้อมูลของ OpenAI | ดัชนีของ Google Search |
| บอตที่ต้องเปิดเพื่อการค้นหา | PerplexityBot | OAI-SearchBot | Googlebot |
| ผู้ใช้เห็นแหล่งที่มาอย่างไร | การอ้างอิงแบบมีหมายเลขในทุกคำตอบ | ลิงก์อ้างอิงเมื่อ ChatGPT ค้นเว็บ | ปุ่มแหล่งข้อมูลใต้คำตอบ ซึ่งไม่ได้มีในทุกคำตอบ |
รายละเอียดของ 2 แพลตฟอร์มนั้นอยู่ในบทความ ChatGPT SEO และ Gemini SEO สำหรับ Perplexity มี 2 เรื่องที่ต้องจำเพิ่ม ระบบตัดหน้าที่ล้าสมัยออกตั้งแต่รอบแรก และผู้ใช้เห็นแหล่งที่มาทุกครั้งที่ถาม
ลูกค้ามักถามเราว่าต้องทำงานแยกสำหรับ Perplexity หรือไม่
ไม่ต้องแยกเป็นงานใหม่ทั้งหมด หน้าที่ตอบคำถามชัด ข้อมูลที่เป็นปัจจุบัน และชื่อแบรนด์บนเว็บไซต์อื่นในหมวด ใช้ได้กับ ChatGPT, Gemini และ AI Overviews ของ Google ด้วย Perplexity เพิ่มงานตรวจ 3 อย่าง ได้แก่ PerplexityBot ในไฟล์ robots.txt และไฟร์วอลล์ วันที่แก้ไขล่าสุดบนหน้าสำคัญ และชุดคำถามที่ถามใน Perplexity แยกจากแพลตฟอร์มอื่น
งานวิจัย GEO พบอะไรเมื่อทดสอบกับ Perplexity
งานวิจัยต้นฉบับของ GEO (Generative Engine Optimisation) ทดสอบวิธีแก้หน้าเว็บกับ Perplexity และพบว่าคำพูดอ้างอิงกับตัวเลขสถิติทำให้ข้อความจากหน้านั้นถูกใช้ในคำตอบมากขึ้น ส่วนการยัดคีย์เวิร์ดได้ผลแย่กว่าหน้าเดิม งานวิจัยของ Pranjal Aggarwal และคณะ ทดสอบกับคำถาม 200 ข้อ ผู้วิจัยระบุว่า Perplexity ไม่ให้ผู้ใช้กำหนดหน้าเว็บที่เป็นแหล่งข้อมูลเอง จึงอัปโหลดข้อความของแหล่งข้อมูลเป็นไฟล์ แล้วให้ Perplexity ตอบจากไฟล์เหล่านั้นเท่านั้น
ผลบน Perplexity มีดังนี้
- การเพิ่มคำพูดอ้างอิงได้ผลดีที่สุดตามตัวชี้วัดหลักของงานวิจัย ซึ่งวัดสัดส่วนข้อความจากหน้านั้นในคำตอบ โดยเพิ่มขึ้น 22% จากหน้าเดิม
- การเพิ่มตัวเลขสถิติเพิ่มผลราว 37% ตามตัวชี้วัดที่ให้โมเดลภาษาประเมินว่าข้อความจากหน้านั้นมีน้ำหนักในคำตอบแค่ไหน
- การยัดคีย์เวิร์ดได้ผลแย่กว่าหน้าเดิม 10%
ผลนี้แปลเป็นงานบนหน้าเว็บได้ตรงๆ ใส่คำพูดของผู้เชี่ยวชาญในบริษัทพร้อมชื่อและตำแหน่งจริง ใส่ตัวเลขที่คุณวัดเองพร้อมช่วงเวลาที่วัด และใช้คีย์เวิร์ดเฉพาะในประโยคที่ต้องใช้
AI อ้างอิงเว็บไซต์ของแบรนด์บ่อยแค่ไหน
เว็บไซต์ของแบรนด์ส่วนใหญ่ถูกอ้างอิงไม่ถึง 1 ใน 5 คำตอบ ในเดือนที่ผ่านมา Elevate, Primal’s AI Visibility Tracker เก็บคำตอบของ AI ได้ 285,098 คำตอบ จากคำถามในหมวดสินค้าและบริการของ 171 แบรนด์ ค่ากลางคือเว็บไซต์ของแบรนด์ถูกอ้างอิงในราว 1 ใน 5 คำตอบเกี่ยวกับหมวดของตัวเอง
แผนภูมิด้านล่างแบ่ง 171 แบรนด์ตามสัดส่วนคำตอบที่อ้างอิงเว็บไซต์ของแบรนด์เอง 48 แบรนด์ถูกอ้างอิงไม่ถึง 1 ใน 10 คำตอบ 42 แบรนด์อยู่ที่ 1 ถึง 2 ใน 10 คำตอบ 30 แบรนด์อยู่ที่ 2 ถึง 3 ใน 10 และ 41 แบรนด์อยู่ที่ 3 ถึง 5 ใน 10 มีเพียง 10 แบรนด์ที่เว็บไซต์ของตัวเองอยู่ในคำตอบครึ่งหนึ่งขึ้นไป
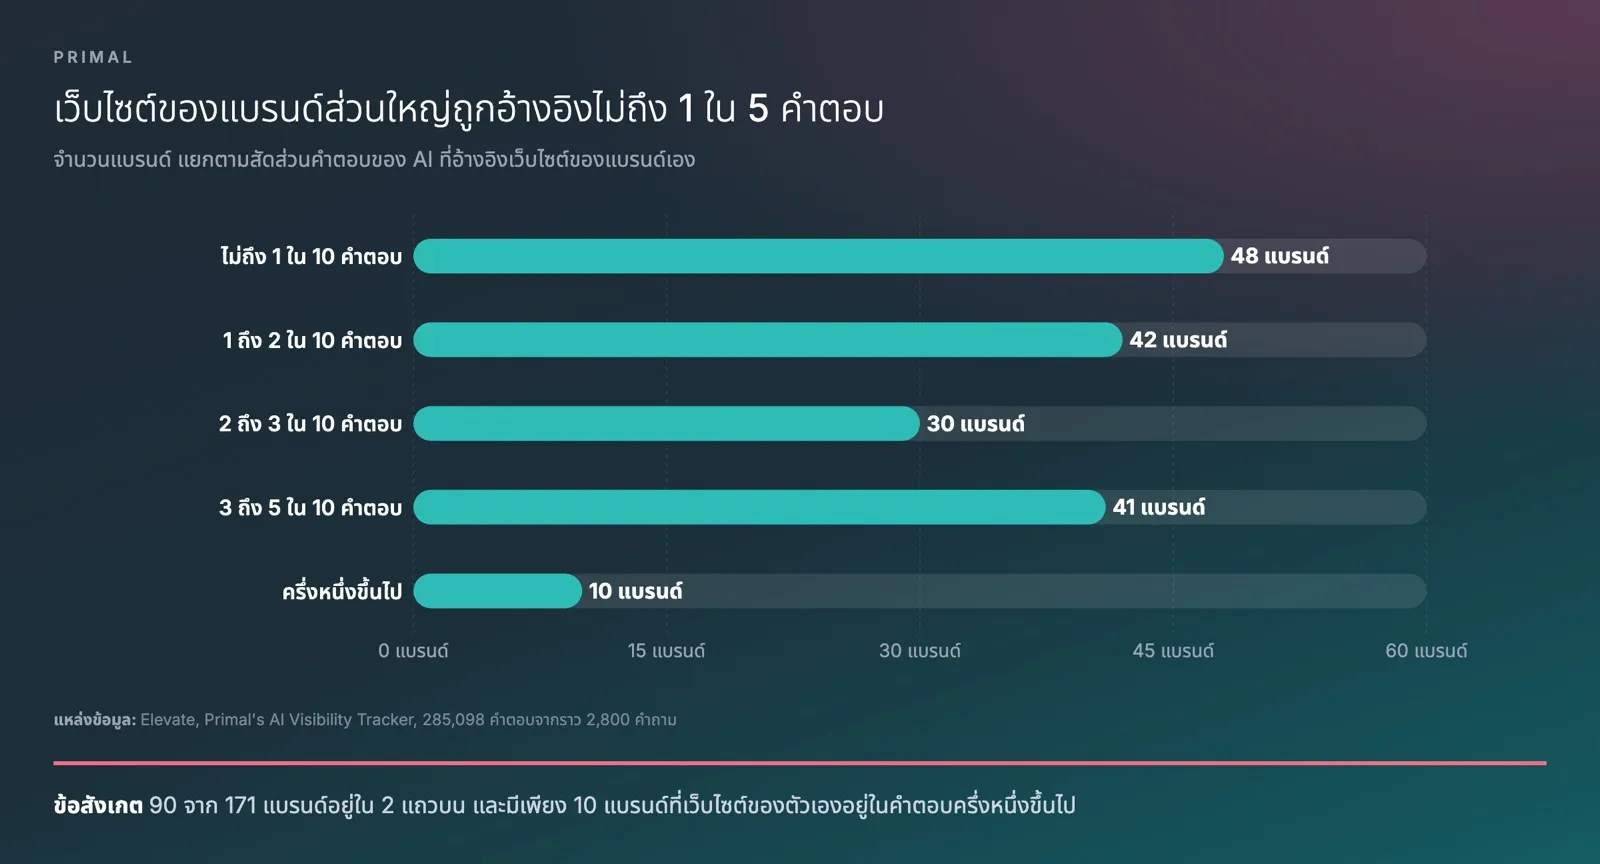
คำตอบในข้อมูลชุดนี้มาจาก AI หลายแพลตฟอร์มรวมกัน ข้อมูลบอกว่าคำตอบส่วนใหญ่อ้างอิงเว็บไซต์อื่น และ Perplexity แสดงเว็บไซต์เหล่านั้นให้เห็นในทุกคำตอบ ถามคำถามของลูกค้า 10 ข้อแล้วจดเว็บไซต์ที่ถูกอ้างอิง คุณจะเห็นรายการเว็บรีวิว สื่อ เว็บชุมชน และโปรไฟล์ที่ควรมีชื่อแบรนด์ของคุณ
แผน 4 สัปดาห์ให้ Perplexity อ้างอิงเว็บไซต์ของคุณ
แผนนี้เริ่มจากเปิดทางให้ PerplexityBot แล้วจึงแก้หน้าเว็บและแหล่งภายนอกตามที่ Perplexity อ้างอิงจริงในหมวดของคุณ แต่ละสัปดาห์มีงาน 1 ชุดและวิธีตรวจว่างานเสร็จ
| สัปดาห์ | งาน | ตรวจอย่างไร |
|---|---|---|
| 1 | เปิด PerplexityBot ในไฟล์ robots.txt และตั้งกฎ WAF ที่รับชื่อ User Agent คู่กับที่อยู่ IP ที่ Perplexity เผยแพร่ | ไฟล์ Log ของเซิร์ฟเวอร์มีคำขอจาก PerplexityBot ที่ได้รหัสสถานะ 200 |
| 2 | เขียนคำถามที่ลูกค้าถามจริง 20 ข้อ ถามใน Perplexity แล้วจดเว็บไซต์ที่ถูกอ้างอิงในแต่ละคำตอบ | ตาราง 20 แถว มีคำถาม เว็บไซต์ที่ถูกอ้างอิง และวันที่ถาม |
| 3 | แก้หน้าที่ตอบคำถามเหล่านั้น ตั้งหัวข้อเป็นคำถาม ตอบจบใน 1 ถึง 2 ประโยคแรก เพิ่มตัวเลขที่วัดเอง คำพูดพร้อมชื่อและตำแหน่ง ชื่อผู้เขียน และวันที่แก้ไขล่าสุด | อ่านเฉพาะประโยคแรกของแต่ละหัวข้อแล้วยังได้คำตอบครบ |
| 4 | อัปเดตโปรไฟล์ รีวิว และข้อมูลแบรนด์บนเว็บไซต์ภายนอกที่ Perplexity อ้างอิงในสัปดาห์ที่ 2 และติดต่อสื่อที่ถูกอ้างอิงบ่อย | ถามคำถาม 20 ข้อเดิมอีกครั้ง แล้วเทียบกับตารางของสัปดาห์ที่ 2 |
คำถามในสัปดาห์ที่ 2 ควรเป็นคำที่ลูกค้าพิมพ์จริงตามหมวดสินค้า เช่น “ประกันสุขภาพผู้สูงอายุแบบไหนคุ้ม” มากกว่าคำถามที่มีชื่อแบรนด์ของคุณ เพราะลูกค้าที่ยังไม่รู้จักแบรนด์จะถามตามหมวด
สัปดาห์ที่ 4 ใช้เวลามากที่สุดและเห็นผลช้าที่สุด เพราะขึ้นกับว่าเว็บไซต์ภายนอกแก้ข้อมูลหรือเผยแพร่บทความเมื่อไร ทำต่อเป็นงานรายเดือนหลังจบ 4 สัปดาห์แรก
เหตุผลหนึ่งที่แบรนด์หายไปจากแหล่งอ้างอิงของ Perplexity ไม่เกี่ยวกับเนื้อหาเลย แต่เป็นไฟร์วอลล์ บนเว็บไซต์ของเราเองที่เพิ่งเปิดตัว ระบบป้องกันบอทค่าเริ่มต้นกัน AI crawler ออกไปอย่างเงียบ ๆ ทั้งที่ไฟล์ robots บอกว่ายินดีต้อนรับ การแก้ใช้เวลาไม่กี่นาที ตรวจไฟร์วอลล์ก่อนจะเขียนหน้าใหม่
วัดผล Perplexity SEO อย่างไร
วัดจากชุดคำถามเดิมที่ถามใน Perplexity ทุกเดือน แล้วจด 4 อย่างพร้อมวันที่ ได้แก่ เว็บไซต์ของคุณถูกอ้างอิงหรือไม่ หน้าไหนถูกอ้างอิง แบรนด์ไหนถูกเอ่ยชื่อแทน และข้อมูลแบรนด์ในคำตอบถูกต้องหรือไม่ ถามแต่ละข้อมากกว่า 1 ครั้งก่อนสรุป เพราะคำตอบของ AI ต่างกันได้ในแต่ละครั้งที่ถาม
ข้อมูลด้านเทคนิคดูจากไฟล์ Log ของเซิร์ฟเวอร์ คำขอจาก PerplexityBot บอกว่าระบบยังเข้ามาเก็บหน้าเว็บอยู่ ส่วนคำขอจาก Perplexity-User บอกว่ามีผู้ใช้ถามคำถามที่ Perplexity ต้องเปิดหน้าของคุณเพื่อตอบ
นับการเข้าชมจาก Perplexity ใน GA4 อย่างไร
สร้าง Channel Group ที่กำหนดเองใน Google Analytics 4 (GA4) แล้วใส่ perplexity ไว้ในเงื่อนไขของแชแนลผู้ช่วย AI หน้าความช่วยเหลือของ GA4 ยกตัวอย่างแหล่งที่มาในช่องผู้ช่วย AI ว่ามี ChatGPT, Gemini, Deepseek, Copilot และ Grok โดยไม่มี Perplexity ในตัวอย่าง ส่วนหน้าเรื่อง Channel Group ที่กำหนดเองใส่ perplexity ไว้ในนิพจน์ตัวอย่างแล้ว ขั้นตอนการตั้งค่าอยู่ในบทความการวัดผล AI Visibility
บริการ AI SEO ของ Primal ทำงานนี้ต่อเนื่องให้แบรนด์ในไทย เริ่มจากติดตามคำถามของลูกค้าคุณในแพลตฟอร์ม AI ที่ลูกค้าใช้ด้วย Elevate, Primal’s AI Visibility Tracker แล้วแก้ทั้งหน้าเว็บและแหล่งอ้างอิงภายนอกตามที่ข้อมูลแสดง
คำถามที่พบบ่อยเกี่ยวกับ Perplexity
Perplexity ใช้ผลการค้นหาของ Google หรือไม่
Perplexity ค้นจากดัชนีค้นหาของตัวเอง ทีมวิศวกรของ Perplexity เขียนไว้ว่าเวอร์ชันแรกส่งคำถามไปยังบริการค้นหาของบริษัทอื่น แล้วจึงสร้างดัชนีของตัวเอง เพราะบริการเหล่านั้นแพงและไม่เหมาะกับคำตอบของ AI หน้าที่ติดอันดับบน Google จึงต้องตรวจใน Perplexity แยกต่างหาก
ปิดกั้นไม่ให้ Perplexity ใช้เนื้อหาบนเว็บไซต์ได้อย่างไร
ใส่บรรทัด Disallow ให้ PerplexityBot ในไฟล์ robots.txt แล้วรอได้ถึง 24 ชั่วโมงให้ระบบปรับตาม Perplexity-User โดยทั่วไปไม่ทำตามไฟล์ robots.txt การปิดกั้นตัวนี้จึงต้องตั้งที่ไฟร์วอลล์ Perplexity แนะนำให้เปิด PerplexityBot ถ้าต้องการให้เว็บไซต์ปรากฏในผลการค้นหาของ Perplexity
ต้องจ่ายเงินหรือเป็นพาร์ตเนอร์ของ Perplexity ไหม จึงจะถูกอ้างอิง
ไม่ต้อง เอกสาร Crawler ของ Perplexity ระบุเพียงให้เปิด PerplexityBot และที่อยู่ IP ที่เผยแพร่ ถ้าต้องการให้เว็บไซต์ปรากฏในผลการค้นหา หน้าเรื่อง Source Label ระบุว่าการเป็นพาร์ตเนอร์และการจ่ายเงินไม่มีผลกับป้าย ส่วนโปรแกรมสำหรับผู้เผยแพร่ของ Perplexity มีไว้แบ่งรายได้ให้สำนักข่าวและผู้เผยแพร่ที่เนื้อหาถูกอ้างอิง
คำตอบหนึ่งของ Perplexity อ้างอิงกี่แหล่ง
จำนวนต่างกันตามคำถามและโหมดที่ใช้ หน้าความช่วยเหลือของ Perplexity ระบุว่าทุกคำตอบมีการอ้างอิงแบบมีหมายเลข ส่วนโหมด Research ค้นหลายสิบครั้งและอ่านแหล่งข้อมูลหลายร้อยแหล่งก่อนเขียนรายงาน วิธีที่เร็วที่สุดคือถามคำถามของลูกค้าแล้วดูรายการแหล่งที่มาใต้คำตอบ
Founder and Chief Executive Officer
Mark McDowell เป็นผู้ก่อตั้งและประธานเจ้าหน้าที่บริหาร (CEO) ของ Primal โดยเริ่มต้นบริษัทที่กรุงเทพฯ ในปี 2015 เขาติดอันดับ Forbes 30 Under 30 Asia ปี 2020 และได้รับรางวัล Southeast Asia Young Achiever of the Year จาก Campaign Asia ในปี 2018 เขาเขียนบทความเรื่อง AI Search และการทำ SEO (Search Engine Optimisation)
เกี่ยวกับผู้เขียน